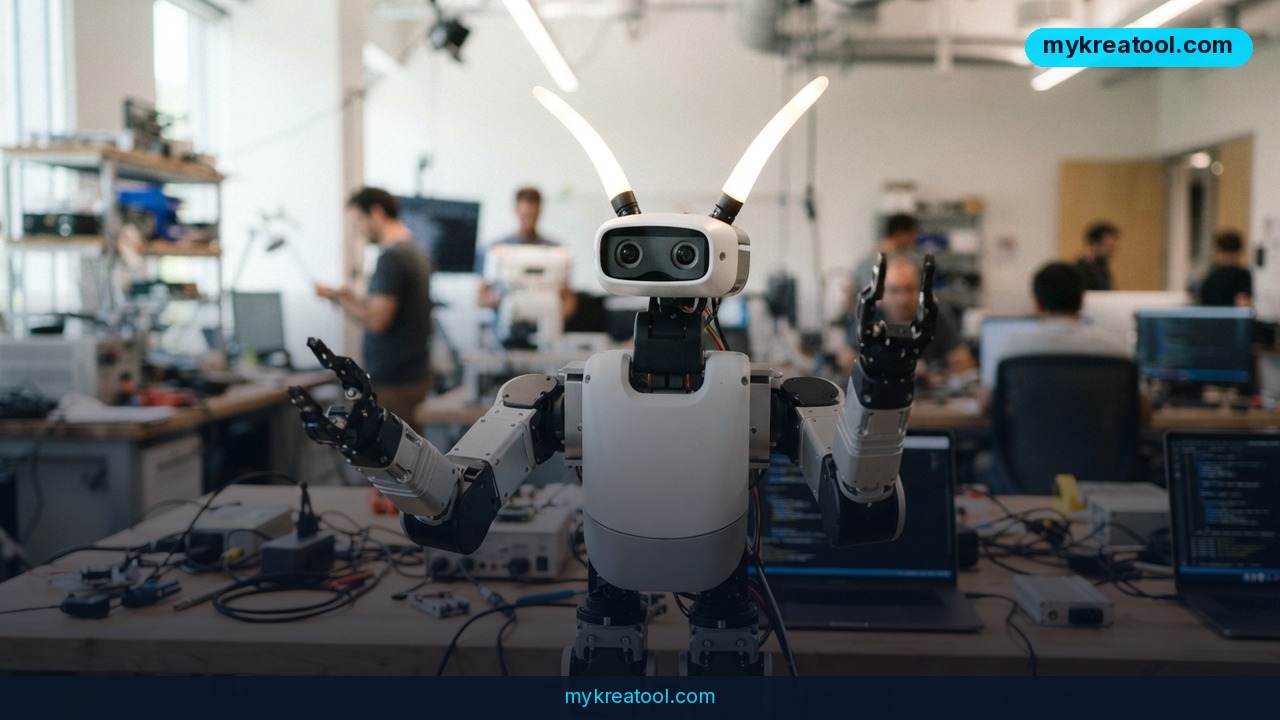
Озвучка текста получила важное обновление: ElevenLabs выпустила Eleven v4. В слепых тестах 75% слушателей выбрали именно её голос, не зная, где чья запись. Компания называет новинку не просто expressive, а emotive: это TTS-модель, которая передаёт настоящие эмоции — иронию, волнение, усталость, радость.
Что вообще случилось
TTS (text-to-speech) — это технология, которая читает текст вслух голосом. Ещё недавно такие голоса узнавались с первой секунды: ровная интонация, одинаковые паузы, ноль настроения. Eleven v4 — новая версия от ElevenLabs, и она эту границу перешагнула.
Самое важное, что стоит знать:
• 28 сентября 2026 года вышли сразу две модели: Eleven v4 и Eleven v4 Turbo.
• v4 взяла первое место в рейтинге Artificial Analysis, обзор запуска есть на VKTR.
• 75% слушателей в слепых тестах предпочли её голос другим вариантам. Это значит: три человека из четырёх на слух не смогли отдать предпочтение конкуренту.
• Turbo — это быстрый вариант с низкой задержкой (разбор запуска на Unite.AI), то есть голос отвечает почти мгновенно. Критично, когда речь нужна не в готовом ролике, а в живом разговоре.
Разница между expressive и emotive — не маркетинговая игра слов. Expressive-модели «играли» интонацией по нотам, как школьник на утреннике. Emotive-модель передаёт настроение так, что ты слышишь человека, а не синтезатор. В документации ElevenLabs это прописано как главная фишка, а краткая карточка модели лежит на Venice.ai.
Робот, который показывает эмоции антеннами
Чтобы ты понял, насколько это живо, вот свежая демонстрация. Модель засунули в Reachy Mini — это небольшой робот с антеннами вместо бровей — и попросили показывать антеннами те же эмоции, которые голос выдаёт речью. Получилось синхронно: голос волнуется, антенны нервно подрагивают; голос радуется, антенны взлетают вверх.
Самое интересное здесь не робот, а то, кто всё это сделал. Всё — от программирования робота до монтажа видео — вытянул Opus 5.5. Человек в этой истории только нашёл камеру и подобрал ракурс. Идеи для демок бесконечно генерировал друг по имени Сева, и автор честно признаётся: в мире агентов только идеи теперь чего-то и стоят.
Если один человек с камерой и ИИ-агентом может собрать такое, представь, что ты можешь сделать со своим контентом, рекламой или уроками.
Что это даёт лично тебе
• Мама двоих детей, которая устаёт читать на ночь. Она пишет короткую сказку сама, выбирает тёплый спокойный голос, добавляет подсказку «читай тихо и с улыбкой» — и получает готовый аудиофайл. Ребёнок слушает, мама отдыхает, а сказка может быть про их собственную семью, а не про абстрактного колобка.
• Владелец кофейни. Ему нужны приветствие на входе, объявление про новый десерт и голос в рекламном ролике. Раньше на это искали диктора и платили за каждую правку. Теперь он меняет текст — и получает новую озвучку за минуту, тем же голосом.
• Фрилансер-дизайнер. Он отправляет клиенту не просто презентацию, а видео с закадровым голосом: что изменилось, почему так, что дальше. Клиент смотрит один раз и всё понимает — а следовательно, меньше правок и быстрее оплата.
• Студент или репетитор. Конспекты, статьи и параграфы превращаются в аудио и слушаются в дороге, в спортзале, на прогулке. Это самый простой способ забрать у рутины час-два в день.
• Продавец на маркетплейсе. Ролик товара с живым голосом вместо титров и музыки — может повысить вовлечённость, потому что люди смотрят видео со звуком, а не читают мелкий текст.
• Автор Telegram-канала. ИИ-озвучка текста открывает аудиоверсии постов: подписчик в пробке не читает, а слушает. Контент работает ещё раз, без новых затрат времени.
Как попробовать прямо сейчас
1. Открой ElevenLabs, зарегистрируйся и вставь в поле для озвучки короткий текст: 2–3 абзаца. Смотри лимиты бесплатного доступа прямо на сайте — они меняются, поэтому лучше видеть их своими глазами.
2. Выбери голос под задачу. Проблема выбора решается просто: озвучь один и тот же абзац тремя-четырьмя голосами и слушай подряд. Тот, на котором ты забыл, что это синтез, — твой.
3. Дай эмоциональную подсказку. Не пиши просто «прочитай текст». Напиши, кто и в каком состоянии это говорит: «прочитай так, будто ты устал, но искренне рад клиенту», «прочитай с лёгкой иронией, как старый друг». Именно на этом v4 раскрывается.
4. Скачай и вставь в дело. Готовый файл уходит в Reels, Shorts, презентацию, видеоурок, автоответчик или в пост канала.
5. Нужен живой диалог — бери Turbo. Если голос должен отвечать сразу, без паузы, выбирай Eleven v4 Turbo: он создан для низкой задержки, то есть для разговора в реальном времени.
6. Нужны детали — иди в документацию. Там по шагам расписано, что умеет v4, какие есть параметры и как встроить озвучку в своё приложение.
Что изменится через полгода
Ещё вчера, чтобы получить профессиональный голос, нужно было найти диктора, согласовать смету, записать, потом переписать из-за одной ошибки в тексте. Сегодня ты правишь предложение в блокноте и получаешь новую версию сразу — тем же голосом и с той же интонацией. Это не «немного дешевле», это другой порядок затрат: подготовка озвучки занимает минуты вместо дней.
Через месяц-полгода это будет выглядеть так: у обычного человека появится личный голос для рабочих видео, аудиокнига для ребёнка, озвученные инструкции для сотрудников, реклама для своего маленького бизнеса. Инструмент может упростить подготовку озвучки для небольших команд.
Честно про минусы
Эмоции в v4 всё равно начинаются с тебя: если подсказка пустая и текст написан канцеляритом, голос прочитает канцелярит — просто выразительно. 75% в слепых тестах — отличный результат, но это не абсолютная гарантия: каждому четвёртому слушателю всё ещё ближе другой голос. И для длинных проектов стоит заранее смотреть условия и лимиты на сайте, чтобы не упереться в них в самый неподходящий момент.
Сделай одно действие уже сегодня
Озвучка текста перестала быть услугой для больших компаний — это кнопка в браузере, доступная тебе лично. Сделай сегодня одно простое действие: зайди на ElevenLabs, возьми свой обычный рабочий текст — письмо клиенту, описание услуги, абзац из конспекта — и озвучь его с эмоциональной подсказкой. Услышишь разницу своими ушами за десять минут.
Что получилось у тебя — напиши в комментариях в @aigoby, разберём, как выжать из этого максимум.
🎁 Бонус — готовый промпт для живой озвучки
Скопируй и вставь в любой ИИ-чат, подставив свой текст:
```
Ты — редактор текстов для озвучки. Возьми мой текст ниже и подготовь его для эмоциональной TTS-модели.
1. Разбей длинные предложения так, чтобы хватало дыхания: одна мысль — одна фраза.
2. Расставь паузы (тире, многоточия) там, где голос должен задуматься или сделать акцент.
3. Убери канцелярит и цепочки существительных, замени их живыми глаголами.
4. Добавь в начале одну короткую подсказку для модели: кто говорит, кому и в каком настроении.
5. В конце дай список из 3 мест, где стоит усилить эмоцию.
Мой текст:
[вставь сюда свой текст]
```
Мини-чек-лист перед озвучкой: текст разбит на короткие фразы — есть подсказка про настроение — выбран голос, который подходит аудитории — версия проверена на слух целиком, а не по первому абзацу.
Комментарии 0