Нейросеть для генерации изображений Qwen-Image 2.1 вышла с базовым разрешением 2048×2048 пикселей и умеет вырезать объект с фотографии прямо в прозрачный слой — без Photoshop, масок и десяти минут возни. Модель от Alibaba уже лежит в открытом доступе на Hugging Face вместе с весами для ComfyUI, а попробовать генерацию бесплатно можно прямо сегодня в чате Qwen. Для тех, кто разбирается в киловаттах видеокарты, а не в мегапикселях, — работает даже на игровых картах среднего уровня.
Что вообще произошло: революция в генерации изображений
Alibaba выпустила Qwen-Image 2.1 — одну модель, которая и рисует картинки с нуля (text-to-image), и редактирует готовые (image editing). Раньше это были обычно разные инструменты: один генерирует, другой правит. Здесь всё в одном месте.
Технически внутри — 7 миллиардов параметров (для сравнения, это в разы меньше топовых закрытых моделей, но, по независимым обзорам, результат конкурирует с более тяжёлыми системами). Базовое разрешение — сразу 2048×2048, плюс вытянутые форматы 2752×1536 и 1536×2752 — то есть готовые обои, баннеры и постеры без апскейла.
Самая интересная фишка — нативный RGBA, то есть прозрачность встроена в саму модель, а не прикручена сбоку. Три режима:
• генерирует объект сразу с прозрачным фоном (альфа-канал);
• редактирует уже прозрачные картинки;
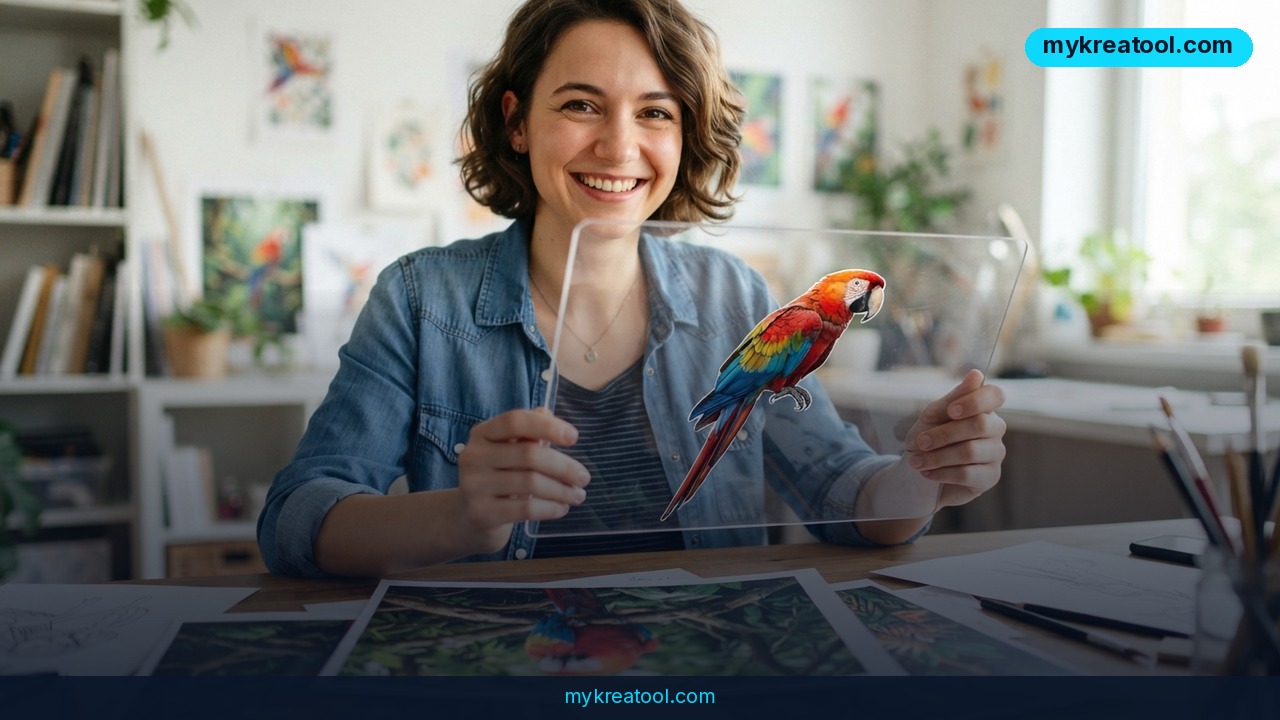
• берёт обычное фото и вытаскивает из него отдельный объект в прозрачный слой — то есть заменяет фотографа с зелёным экраном и часового работника в Photoshop.
Плюс модель принимает до 10 референсных изображений одновременно, понимает правки «на пальцах» — можно обвести нужную область каракулями или маской прямо на картинке, — и лучше держит внешность людей и объектов при редактировании, чтобы лицо на десятой правке не превращалось в другого человека.
Что это даёт лично тебе: нейросеть для создания картинок как инструмент
• Владелец интернет-магазина. Нужны фото товара на белом или прозрачном фоне для маркетплейса — раньше это была отдельная услуга у фрилансера или ретушь руками. Теперь можно сфотографировать товар на телефон и вырезать фон одним запросом.
• SMM-специалист или маркетолог. Нужен баннер под конкретный формат сторис (1536×2752) или квадратный пост в высоком разрешении — модель сразу выдаёт нужные пропорции без обрезки и потери качества.
• Фрилансер-дизайнер. Клиент прислал референс логотипа и просит «сделать похоже, но по-другому» — можно скормить до 10 картинок-примеров разом и получить вариант, который держит стиль, а не рассыпается.
• Мама, которая делает открытки и стикеры для детского праздника. Нарисовала на фото ребёнка каракулями «здесь корону, тут звёзды» — и получила локальную правку именно в этом месте, без переделки всей картинки.
• Автор блога или канала. Нужна уникальная обложка для статьи под нужный текст (модель умеет прилично вписывать текст в изображение — улучшена типографика) — не нужно идти за стоковыми картинками.
• Владелец кофейни или небольшого бизнеса. Есть фото продукта на фоне рабочего стола — можно вырезать сам продукт в прозрачный PNG и собрать красивое меню или лендинг за вечер.
Как попробовать прямо сейчас: генерация изображений бесплатно
Самый простой бесплатный способ — без установки чего-либо на компьютер:
1. Открой Qwen Chat — это официальный веб-чат Alibaba, доступен бесплатно.
2. Выбери режим генерации изображений и опиши задачу текстом: например, «сгенерируй логотип кофейни на прозрачном фоне» или «вот фото товара, вырежи его без фона».
3. Если нужна точечная правка — загрузи своё изображение и обозначь область каракулями или маской прямо в интерфейсе, опиши словами, что там должно быть.
4. Для сложных задач с несколькими образцами — загрузи до 10 референсных картинок разом и опиши, что нужно получить на выходе.
5. Скачай результат — при работе с прозрачностью сохраняй в PNG, чтобы альфа-канал не потерялся.
Для тех, кто хочет запустить модель локально (например, для потокового изготовления карточек товаров): веса лежат на Hugging Face, а Comfy Org уже выпустила готовый набор для ComfyUI с поддержкой «с нулевого дня». По отчётам пользователей на Reddit, модель в квантизованном виде (INT8, около 7 ГБ) плюс текстовый энкодер (около 6 ГБ) — это порядка 13 ГБ суммарно, и ComfyUI умеет часть данных держать в обычной оперативке. Так что видеокарта с 12 ГБ видеопамяти уже комфортный вариант, а на слабых картах вроде RTX 3060 модель, по предварительным тестам сообщества, тоже заводится при агрессивной квантизации.
Что стало лучше и в чём подвох: ии для генерации изображений и его особенности
Из плюсов: не нужно платить за отдельный сервис по удалению фона (условный remove.bg) и отдельно за генерацию картинок — одна модель закрывает обе задачи, причём бесплатно через веб-чат. Через несколько месяцев, когда сообщество докрутит квантизацию, обработка фото для маркетплейсов и соцсетей на обычном игровом ноутбуке станет рутинной операцией, а не поводом нанимать ретушёра.
Из минусов, честно: лицензия у модели — исследовательская (research), то есть с ограничениями на коммерческое использование, это стоит проверить перед тем, как ставить результат в продающий лендинг напрямую через локальный запуск (в облачном Qwen Chat условия использования могут отличаться — уточняй в самом сервисе). Часть пользователей на Reddit также жалуются на «эффект пластиковой кожи» на портретах — то есть глянцевую, неестественную кожу на лицах, это известное ограничение подобных моделей, а не глюк лично у тебя.
Независимые источники, где это подтверждено: официальный блог Qwen, разбор The Decoder, страница Comfy Org, обзор AI Weekly.
Вывод: будущее с нейросетью для картинок
Попробуй сегодня же: зайди в Qwen Chat, загрузи любое фото товара или своё селфи и попроси вырезать объект на прозрачный фон — это займёт пару минут и покажет тебе, стоит ли встраивать инструмент в свою рутину. Результатами и багами (та самая «пластиковая кожа») делись в комментариях у @aigoby — собираем реальные тесты от читателей.
🎁 Бонус — промпт для быстрого старта:
```
Извлеки главный объект с этого фото в отдельный слой с прозрачным фоном (RGBA), сохрани мелкие детали по краям (волосы, тонкие элементы), не меняй цвет и освещение объекта.
```
✅ ГОТОВО
Комментарии 0