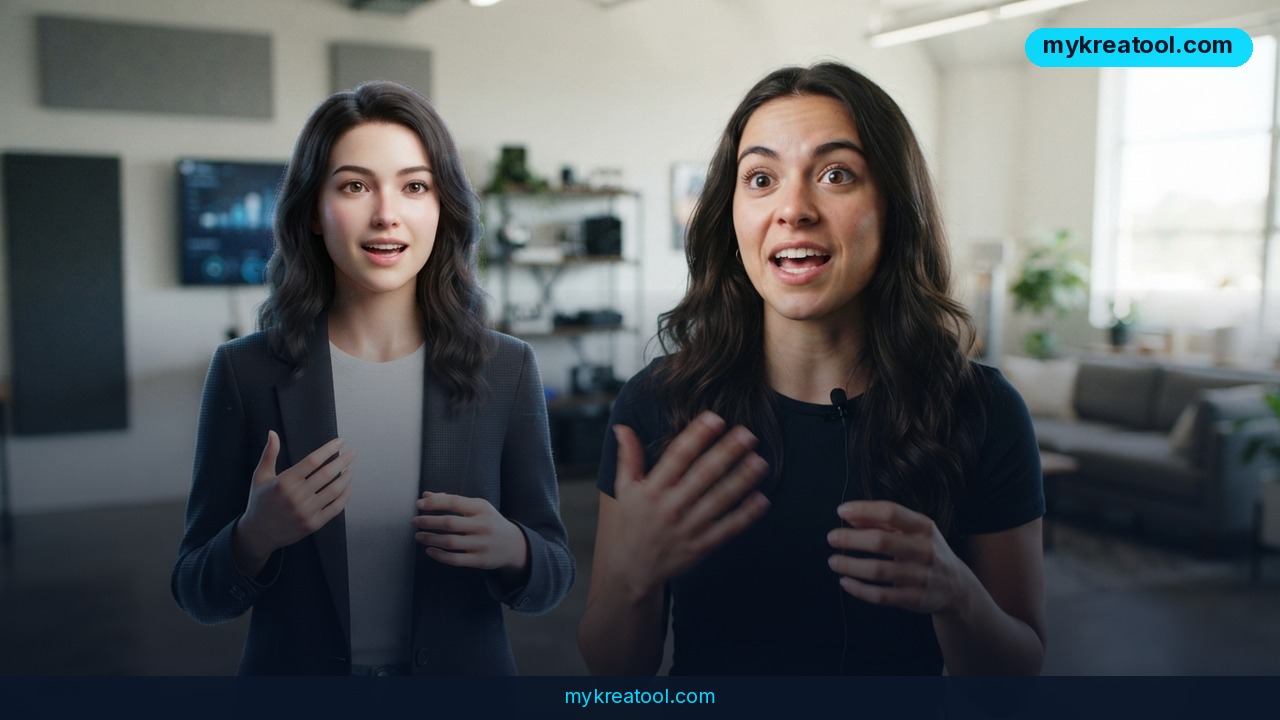
Теперь говорящий аватар можно собрать самому: Сбер открыл исходный код Kandinsky Avatar 1.0, и бесплатная нейросеть для видео умеет делать ролики до 60 секунд. Модель работает с частотой 24 кадра в секунду, синхронизирует артикуляцию с речью, добавляет мимику, движения головы и жесты. Для генерации хватает трёх вещей: изображения, аудиозаписи и текстового описания сцены. Обучали её более чем на миллионе видеофрагментов на 95 языках — поэтому нейросеть для говорящего аватара умеет синхронизировать губы с речью на разных языках.
Что случилось на самом деле: Нейросеть для видео меняет правила игры
Сбер сделал доступным Kandinsky Avatar 1.0 — это модель для создания видео с говорящим аватаром. «Открытый доступ» здесь значит не «посмотреть картинки», а «взять код и использовать его в своих проектах». Код лежит на Hugging Face, а на странице проекта можно посмотреть, как это работает.
Слово «бесплатно» тут про код: сама модель открыта, а вот железо для запуска может стоить денег — особенно для Pro в HD. Разработчикам доступны две версии. Pro делает видео в HD, и, по оценке Сбера, качество сопоставимо с HeyGen IV. Lite создаёт ролики в SD, но её можно запустить на домашней видеокарте — это важно, если не хочешь арендовать облако. Сбер открыл модели для коммерческого использования: на их основе можно делать виртуальных консультантов, образовательные сервисы, инструменты локализации и приложения для создания видеоконтента. Новость подтверждают sostav.ru и ichip.ru.
Что это даёт лично тебе: Оживление фото и создание видео без усилий
Самое интересное начинается, когда смотришь не на модель, а на людей, которым она экономит время.
• Владелец кофейни. Он давно хотел рассказывать в соцсетях об акциях, но стесняется камеры и не хочет каждый раз собирать свет. Записал короткое аудио, сделал фото, добавил описание сцены — и получил ролик до 60 секунд, где его аватар говорит и улыбается. Без съёмочной команды.
• Мама двоих детей, которая ведёт развивающий канал. Она озвучивает сказку, подбирает картинку персонажа и получает говорящий аватар. Модель поддерживает разные языки, поэтому можно записать ту же сказку на другом языке и показать её более широкой аудитории.
• Фрилансер-дизайнер. Клиент просит локализовать рекламный ролик. Дизайнер меняет аудиодорожку, и аватар синхронизирует губы с новой речью. Это уже не «просто картинка», а готовая услуга, за которую можно брать деньги.
• Репетитор по математике. Он записывает короткие объяснения тем на телефон, подставляет своё фото — и получает видео до 60 секунд для учеников. Не нужно ставить свет, искать фон и переснимать дубли.
• Предприниматель с сайтом-визиткой. Он заказывает разработчику виртуального консультанта на основе открытого кода. Посетитель сайта видит говорящего человека, который отвечает на частые вопросы, а не скучный текст.
Это не обещание заработка, а примеры того, где создание видео с ИИ уже сегодня может сэкономить время или стать новой услугой.
Как попробовать прямо сейчас: Бесплатная нейросеть для создания видео
Если хочется потрогать руками, вот короткий маршрут.
1. Открой страницу проекта. Посмотри примеры: там видно, как двигается голова, как работает мимика и синхронизация губ.
2. Зайди на Hugging Face. Это страница модели Kandinsky-S2V-1.0-Pro-distill-Diffusers. Там лежат файлы и описание — с этого начинают разработчики.
3. Подбери версию. Pro — если нужен HD и есть ресурсы. Lite — если хочешь запустить на домашней видеокарте и готов к SD.
4. Подготовь три вещи: изображение с лицом или персонажем, аудиозапись речи и текстовое описание сцены. Например: «женщина в светлой рубашке сидит у окна, мягкий дневной свет, смотрит в камеру, спокойно говорит, слегка улыбается».
5. Запусти генерацию. Если не хочешь разбираться с кодом, сравни с HeyGen — это сервис, с которым Сбер сравнивает качество Pro-версии. Так проще понять, как смотрится результат, а не настраивать модель.
6. Помни про коммерческое использование. Сбер открыл модели для коммерческого использования, но условия лучше посмотреть на странице модели.
Плюсы, минусы и честные ограничения нейросети для генерации видео
Плюсы. Код открыт, и это главное. Раньше говорящие аватары жили в закрытых сервисах, теперь модель можно взять и построить на ней что-то своё. Поддерживаются разные языки, обучение шло на более чем миллионе видеофрагментов на 95 языках. Частота — 24 кадра в секунду, есть мимика, движения головы и жесты. Для генерации не нужна студия: изображение, аудио и описание сцены. Pro-версия делает HD, Lite — SD и запускается на домашней видеокарте. Коммерческое использование разрешено.
Минусы. Ролики пока до 60 секунд — на длинный фильм не замахнёшься. Чтобы запустить самому, нужны технические навыки и подходящая видеокарта. Pro в HD — требует больше ресурсов, чем Lite. Качество Pro Сбер сравнивает с HeyGen IV, но это оценка компании, а не независимый тест. И главное: Сбер открыл код, а не готовую кнопку «сделать видео». Если не хочешь разбираться, придётся либо ждать сервисов на основе модели, либо использовать готовые решения вроде HeyGen.
Что в сухом остатке: Оживление фото нейросетью – стоит ли?
Kandinsky Avatar 1.0 — это не игрушка на вечер, а рабочий инструмент, который стал доступен обычным людям и небольшим командам. Ты можешь делать говорящие видео без камеры, света и монтажёра, если готов чуть-чуть разобраться или нанять человека. Через месяц-полгода наверняка появятся сервисы, которые завернут эту модель в удобный интерфейс, но начать можно уже сейчас.
Сделай одно действие сегодня: открой демо-страницу проекта и посмотри ролик. Если хочешь, чтобы разобрали твой сценарий, напиши в комментариях в @aigoby.
🎁 Бонус: промпт для первого ролика с нейросетью для видео бесплатно
Скопируй описание сцены и подставь свои детали — это то самое текстовое описание, которое нужно модели вместе с изображением и аудио.
```text
Молодая женщина в светлой рубашке сидит у окна. Мягкий дневной свет падает на лицо, фон слегка размыт. Она смотрит прямо в камеру и спокойно говорит, слегка улыбается, кивает в такт словам, делает лёгкие жесты руками. Настроение дружелюбное и уверенное. Кадр средний. Длительность — до 60 секунд.
```
Чек-лист перед запуском:
• [ ] изображение с чётким лицом и нормальным освещением;
• [ ] аудио без шума и пауз;
• [ ] описание сцены на пару предложений;
• [ ] длительность ролика не больше 60 секунд;
• [ ] проверка губ, мимики и движений головы после генерации.



Комментарии 0