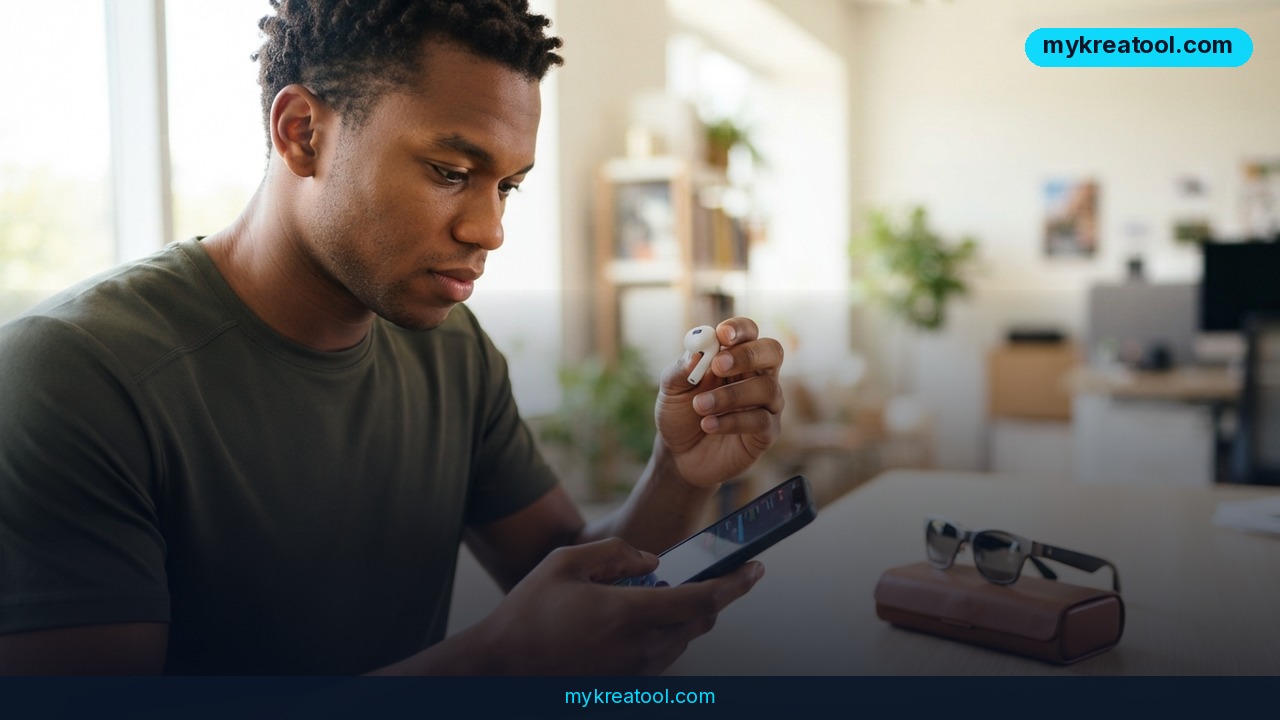
Умные очки Subvocal, собравшие $1,3 млн, обещают превращать тихую речь в текст быстрее 200 слов в минуту. А через день разработчик Joe Blau собрал похожий эксперимент для AirPods Pro 3 всего за 9 минут с помощью AI-кодинга. Приложение ловит микродвижения акселерометром и гироскопом около 25 раз в секунду.
Что вообще произошло
Разберём по-человечески. Subvocal делает умные очки, которые должны работать как невидимый переводчик: ты беззвучно шевелишь губами, а на экране появляется готовый текст. Фокус в том, что даже беззвучная речь — это крошечные движения мышц лица. Их ловят датчики, а дальше программа превращает сигнал в слова. Заявленная скорость — больше 200 слов в минуту, это примерно темп нормальной речи.
Дальше начинается самое интересное. Через день после новости о $1,3 млн разработчик Joe Blau выложил эксперимент: приложение для AirPods Pro 3, которое пытается делать то же самое, но не через специальные очки, а через обычные наушники. Внутри — акселерометр и гироскоп, те самые датчики, которые понимают, когда ты поворачиваешь голову. Его софт, по сообщениям, читает сигналы около 25 раз в секунду. А собрал он это, по собственным словам, за 9 минут — с помощью AI-ассистированного кодинга, когда нейросеть пишет код по твоему описанию. В англоязычной среде такой подход называют vibecoding.
Здесь важная честная оговорка: прототип Joe Blau — не волшебная замена Subvocal. Это сильно более простая штука: она сопоставляет движения головы с заранее заученными словами, а не читает мышцы лица. Но сам контраст бросается в глаза: с одной стороны — стартап с $1,3 млн и специальным железом, с другой — разработчик с AirPods и девятью минутами. Если хочешь копнуть глубже, вот первоисточники: Digital Trends, Hindustan Times, Startup Fortune и The Venture Codex.
Что это даёт лично тебе
Представь Артёма, у которого кофейня. В час пик вокруг шумно, а ему нужно ответить поставщику. С беззвучной речью он молча формулирует сообщение, а телефон превращает его в текст. Пока это эксперимент, но направление уже понятно: не нужно никуда уходить и повышать голос.
Лиза, фрилансер-дизайнер, сидит на созвоне с клиентом. Руки заняты, говорить вслух неудобно, а правки теряются. Она беззвучно наговаривает их и получает готовый текст, который можно сразу отправить в чат. Это не фантастика, а ровно то, вокруг чего крутятся и Subvocal, и эксперимент Joe Blau.
У Марины на руках ребёнок, а в голове — список покупок. Она беззвучно проговаривает его и получает заметку. Руки свободны, телефон не выпадает, ничего не забыто.
Студент в библиотеке не хочет мешать другим, но ему нужно зафиксировать мысль. Он беззвучно диктует конспект — и получает текст без шума и неловких взглядов.
Предприниматель в самолёте хочет набросать письмо команде, но вокруг люди. Он молча формулирует тезисы, а на экране появляется черновик. Даже если это пока прототип, сам сценарий уже понятен.
И отдельный сценарий — для того, кто устал говорить вслух в опенспейсе. Не всем комфортно наговаривать голосовые на весь офис. Беззвучная речь решает и эту бытовую проблему.
Как попробовать прямо сейчас
Шаг 1. Выбери одну рутину, где тебе неудобно говорить вслух. Например: «ответить поставщику, когда вокруг шумно» или «записать мысль, пока руки заняты».
Шаг 2. Открой любую нейросеть для текста или кода и опиши задачу так, как объяснил бы стажёру. Чем конкретнее, тем лучше.
Шаг 3. Попроси собрать максимально простой прототип: без красивого дизайна, без сервера, только проверка идеи. В этом и суть AI-ассистированного кодинга — ты не зубришь синтаксис, ты ставишь задачу.
Шаг 4. Если у тебя есть AirPods Pro 3, проверь, что вообще получается с датчиками и записью. Если нет — начни с телефона: диктофон, заметки, любая запись. Важно понять принцип.
Шаг 5. Сравни свой результат с тем, что заявляет Subvocal. У них — очки, которые читают мышцы лица. У тебя — эксперимент, который может читать что угодно: движение головы, наклон, ритм. Это не соревнование, это проверка гипотезы.
И не путай это с обратной задачей «текст в речь», где ИИ озвучивает готовый текст; здесь ты молчишь, а текст появляется. Здесь всё наоборот: ты молчишь, а текст появляется.
Плюсы, минусы и куда всё идёт
Главный плюс в том, что барьер входа рушится. Раньше для такой идеи нужен был раунд, команда и специальное железо. Теперь один разработчик с AirPods и AI-ассистентом показывает рабочий эксперимент за 9 минут. Это значит, что через месяц-полгода подобных прототипов станет больше, а функции беззвучного ввода могут появиться в обычных наушниках и умных очках с AI.
Второй плюс — скорость проверки идей. Ты можешь не гадать, а за один заход собрать черновик и понять, работает он или нет. Это экономит время и деньги.
Минусы тоже честные. Прототип Joe Blau — не продукт: он сопоставляет движения головы с заученными словами, а не читает мышцы лица, как обещает Subvocal. У Subvocal — заявка на технологию, а не доказанный массовый продукт. Плюс любые датчики, которые читают твои движения, — это ещё и вопрос приватности. Так что восторг уместен, но без иллюзий.
Вывод и одно действие на сегодня
Главный вывод простой: $1,3 млн больше не гарантируют, что идею не повторят за 9 минут. Для тебя это сигнал — не откладывать собственные эксперименты. Возьми одну рутину, опиши её нейросети и проверь, можно ли собрать для неё простой прототип.
🎁 Бонус с готовым промптом
Скопируй этот промпт в нейросеть и подставь свою задачу:
```
Ты — мой AI-ассистент по быстрым прототипам. У меня есть рутина: [опиши её]. Я хочу за один заход проверить, можно ли сделать для неё простой прототип. Не пиши сложный код. Сначала задай мне 5 уточняющих вопросов, потом предложи самый простой способ проверить гипотезу без специального железа. В конце дай пошаговый план из 9 шагов и список того, что может пойти не так.
```
Комментарии 0